Google Lança Novos Modelos de Interação por Voz com Foco em Fluidez e Complexidade
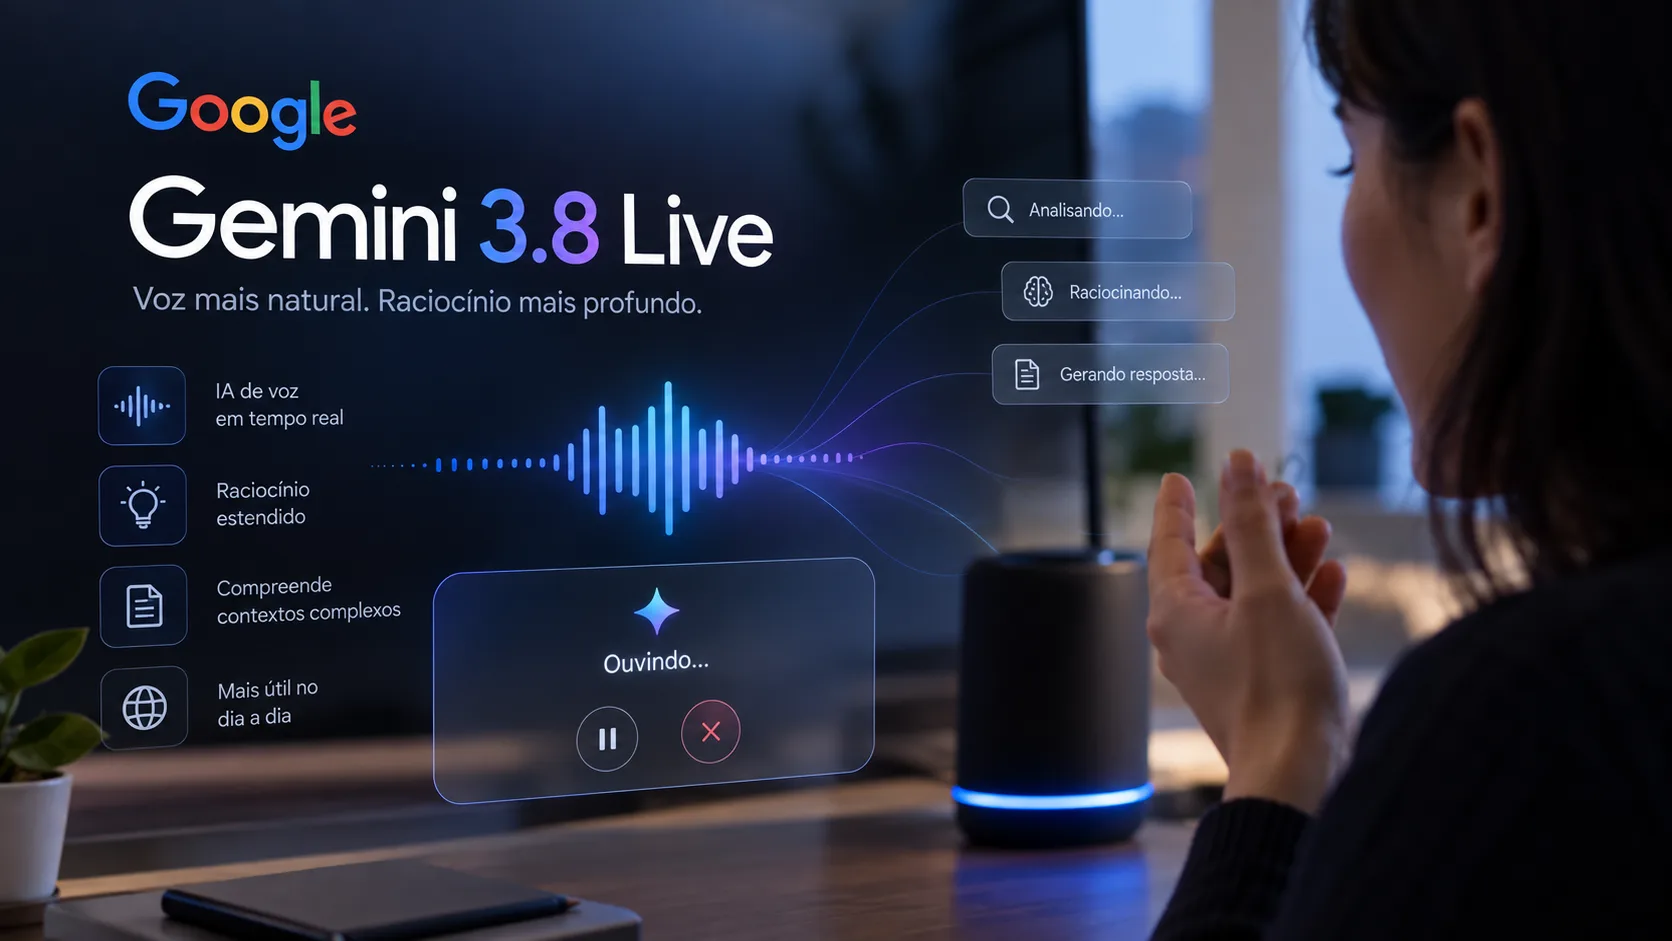
A Google deu um passo significativo na evolução dos assistentes virtuais ao apresentar dois novos modelos de interação por voz: o Gemini 3.8 Live e o Gemini 3.8 Live Extended Thinking. Essas inovações, voltadas para desenvolvedores corporativos e integradas aos aplicativos da empresa, prometem eliminar um dos principais desafios enfrentados pelos assistentes atuais: a interrupção da fluidez durante a execução de tarefas complexas.
Avanços na Interação com Assistentes de Voz
As novas versões dos modelos Gemini permitem uma interação mais natural e contínua. Com a adoção de um sistema de fala para fala, a inteligência artificial é capaz de processar comandos e analisar contextos visuais simultaneamente. Isso significa que a IA pode realizar chamadas de API em segundo plano e responder em tempo real, sem que haja quebras no diálogo.
Uma das mudanças mais notáveis para os usuários é a eliminação do “silêncio constrangedor” enquanto o assistente busca informações. O modelo Extended Thinking, em particular, foi projetado para processar dados e comunicar o progresso de tarefas em tempo real. Quando solicitado a realizar uma tarefa demorada, a IA pode utilizar expressões naturais, como “Deixe-me verificar isso”, informando o usuário sobre cada etapa do processo.
Diferenças Entre os Modelos
A Google estruturou o lançamento em duas vertentes, cada uma adaptada a diferentes requisitos de custo e capacidade computacional:
Gemini 3.8 Live: Este modelo é voltado para eficiência operacional e escalabilidade. Ele combina inteligência conversacional com a habilidade de interpretar imagens e vídeos em tempo real, possibilitando a troca instantânea entre 97 idiomas, mesmo se o usuário mudar de língua durante a conversa.
- Gemini 3.8 Live Extended Thinking: Direcionado a fluxos de trabalho mais complexos, este modelo aplica raciocínio de múltiplas etapas. Segundo a Google, ele alcançou uma pontuação de 82,6 no Speech to Speech Quality Index da Artificial Analysis e obteve 97,7% no Big Bench Audio, que avalia a lógica em modelos sonoros.
Disponibilidade e Integração no Ecossistema Google
Os novos modelos já estão disponíveis para desenvolvedores por meio da Gemini Live API e no Google AI Studio. O custo de operação via API foi estabelecido em US$ 0,005 por minuto de entrada de áudio e US$ 0,018 por minuto de saída. Ferramentas de desenvolvimento como LiveKit, LangChain e Vercel já oferecem suporte para facilitar a infraestrutura de streaming necessária.
No que diz respeito ao consumo, a Google iniciou a implementação gradual do Gemini 3.8 Live no Search Live. O modelo Extended Thinking será integrado ao aplicativo móvel Gemini e às ferramentas do Google Workspace, como Gmail e Docs, para assinantes dos planos Pro e Ultra.
Em termos de segurança, todos os áudios produzidos pelos novos modelos incorporam a tecnologia SynthID. Esta marca d’água invisível é inserida diretamente nos arquivos sonoros, garantindo que sistemas de auditoria possam identificar o conteúdo gerado por inteligência artificial, ajudando a prevenir a desinformação.
Com essas inovações, a Google reafirma seu compromisso em aprimorar a experiência do usuário com assistentes de voz, promovendo uma comunicação mais fluida e eficiente.
Fonte: Link original